Bethesda字符串编辑器
贝塞斯达《星空》AI辅助本地化编辑器——通过Ollama翻译.strings、.dlstrings、.ilstrings、BA2和ESP/ESM文件,支持11种语言(EN/DE/ES/FR/IT/JA/PL/PT-BR/ZH/RU/UK)
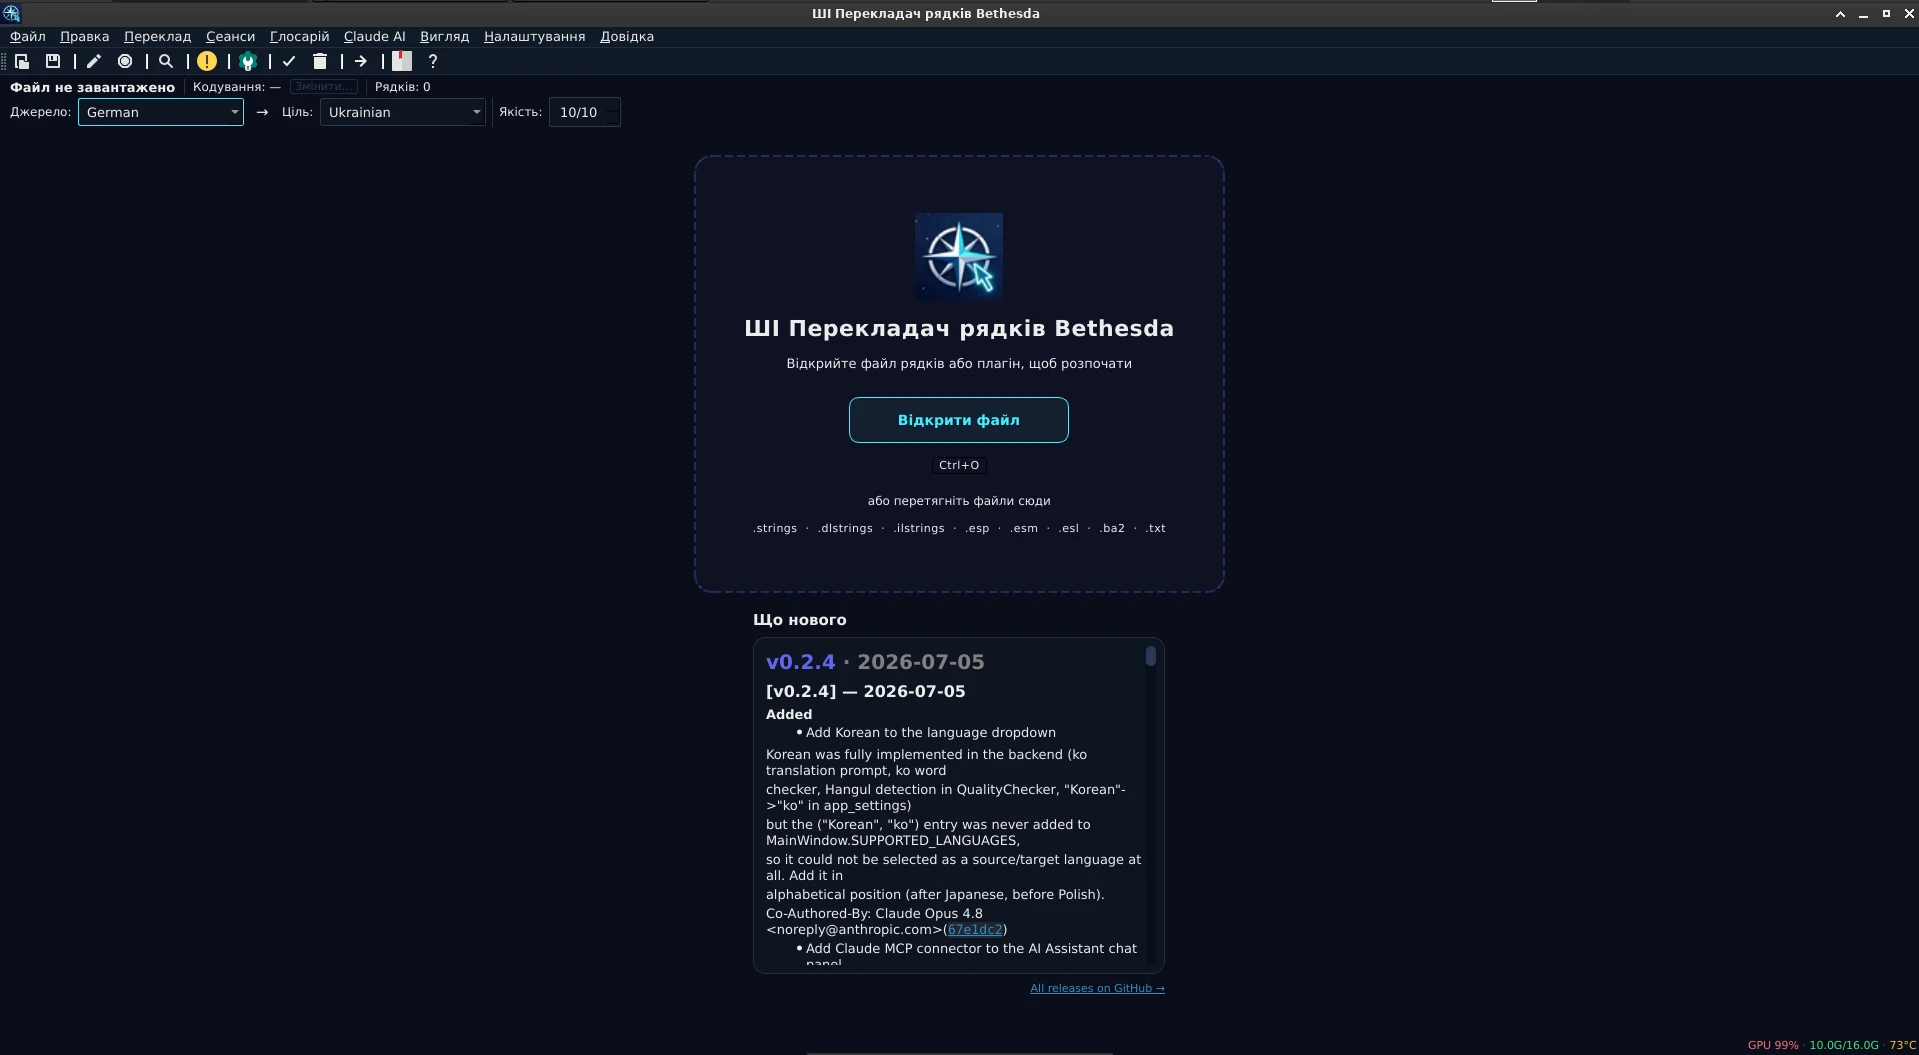 查看大图
一款用于翻译《星空》本地化文件的桌面工具,支持 12 种语言,可使用本地运行的 AI 模型、Claude API 或你的 Claude Code 订阅(无按 token 计费的 API 成本)。
可读取 Creation Engine 使用的二进制字符串格式([b].strings[/b]、[b].dlstrings[/b]、[b].ilstrings[/b]、[b]BA2 归档[/b]、[b]ESP/ESM 插件[/b]以及[b]《星空》界面 TXT[/b] 文件),将文本发送至 Ollama 或 Claude,并将翻译后的文件以原始格式写回——可直接放入你的模组或游戏数据文件夹。
围绕真实的本地化工作流设计:与 xTranslator XML 文件集成,保护数千个《星空》专有名词免遭误译,记住你已批准的每一条字符串,并自动标记质量问题,以便你逐条审查或重译。
[heading]⚠️ “此文件已被自动隔离,可能不安全”[/heading]
如果 Nexus Mods 或你自己的杀毒软件标记了该下载,那是[b]误报[/b]——不是恶意软件。这几乎影响所有使用 [b]PyInstaller[/b] 打包的应用:用于解包内置 Python 运行时的小型启动器存根,在基于签名和机器学习的扫描器看来,与某些恶意软件使用的自解压存根相似。本项目任何地方都没有恶意内容——没有遥测、没有隐藏下载、没有载荷。
而且你不必只信我的一面之词。将其作为[b]免费、开源软件(MIT 许可证)[/b]发布的全部意义就在于任何人都可以自行核查:
[list]
[*][b]阅读代码[/b]——每一行都在 [url=https://github.com/0xra0/bethesda-strings-editor]github.com/0xra0/bethesda-strings-editor[/url] 公开。没有任何混淆、加密或隐藏。[/*]
[*][b]跳过二进制文件,从源码运行[/b]——没有可触发启发式扫描器的打包可执行文件:
[code]git clone https://github.com/0xra0/bethesda-strings-editor
pip install -r requirements.txt
python main.py[/code][/*]
[*][b]用开源杀毒软件扫描[/b]——不要依赖单一闭源专有引擎。[url=https://www.clamav.net]ClamAV[/url] 完全开源,因此其检测逻辑可审计,而非黑箱:
[code]clamscan -r bethesda-strings-editor/[/code][/*]
[*][b]在 VirusTotal 上检查[/b]——上传 zip 后你会看到只有少数启发式/机器学习引擎报警(这是 PyInstaller 误报的典型特征),而绝大多数引擎均通过。[/*]
[*][b]验证构建是否真实[/b]——每个发行版都附带[b]经 GPG 签名的 SHA256SUMS[/b] 文件,因此你可以证明你的下载与公开 GitHub Actions CI 从带标签提交构建的逐字节一致,之后未被改动。完整步骤见仓库中的 [b]VERIFICATION.md[/b]。[/*]
[/list]
为了从源头消除这些标记,PyInstaller 启动器在 CI 运行器上[b]从源码编译[/b](生成唯一字节而非被广泛列入黑名单的预构建存根),而非直接发布现成文件。如果你仍然遇到警告,请张贴确切的文件名及其 SHA-256 哈希,以便我将其作为误报提交给杀毒软件厂商。
[heading]v0.2.5 新增内容[/heading]
[list]
[*][b]UI 宽度适配模拟器[/b]——捕获那些拼写完美但发布后按钮仍被截断的翻译。宽度根据游戏自身字体的真实逐字形步进值测量,对照从游戏自身菜单中读取的控件预算——包括大字体无障碍版本,其中通过普通菜单的标签仍可能被裁剪[/*]
[*][b]玩家性别感知翻译[/b]——只需声明一次玩家角色的性别,而不必让 AI 在乌克兰语、波兰语、德语、俄语及其他有性别区分的语言中逐行猜测[/*]
[*][b]官方术语挖掘器[/b]——直接从基础游戏随附的本地化文件中提取 Bethesda 对每种武器、阵营、UI 动词和任务术语的官方措辞,零 AI 调用(真实安装中 30 秒内可提取 19 万+ 条目)[/*]
[*][b]翻译提示词编辑器[/b]——无需触碰代码即可重新调整 AI 的翻译方式(风格、正式程度、词汇、语法、严谨度),并带有实时预览[/*]
[*][b]韩语助词(조사)检查器[/b]——基于韩文받침算术计算而非猜测;在 5,353 条真实韩语字符串中测得 0 误报[/*]
[*][b]更轻量、更快速[/b]——词表现在按语言对加载而非一次性全部加载(EN→KO 会话中从约 331 MB 降至约 44 MB),翻译记忆模糊查询速度提升约 10 倍且结果相同[/*]
[/list]
[b]值得一提的修复:[/b]以源文本为键的翻译记忆(挖掘器和 TMX 导入产生的所有内容)会报告自身为空并在各处被静默关闭;一旦加载任何 TM,Claude 后端就会将批次中每条字符串都标记为失败;聊天面板的“用作翻译”按钮从未真正生效;性别一致性对话框打开时崩溃;在 Linux 上,当动画背景启用硬件视频解码时应用可能在启动时中止。
完整更新日志:[url=https://github.com/0xra0/bethesda-strings-editor/blob/main/CHANGELOG.md]CHANGELOG.md[/url]
[heading]安装[/heading]
[list=1]
[*]从[b]文件[/b]标签页下载适合你平台的 zip[/*]
[*]解压到任意位置——无需安装 Python 或 Qt,完全自包含[/*]
[*]安装 [url=https://ollama.com]Ollama[/url] 并启动:
[code]ollama serve[/code][/*]
[*]运行 [b]bethesda-strings-editor[/b](Linux)或 [b]bethesda-strings-editor.exe[/b](Windows)[/*]
[/list]
[b]可选——Claude Code 后端(无 API 成本):[/b]如果你已付费订阅 Claude [b]Pro / Max[/b],请安装 [url=https://claude.com/claude-code]Claude Code[/url],运行一次 [b]claude[/b] 登录,然后在设置中选择 [b]Claude Code[/b] 模型([b]claude-code:haiku[/b] / [b]:sonnet[/b] / [b]:opus[/b])。翻译、聊天和审查均通过本地 [b]claude[/b] CLI 在你的订阅上运行——无需 Anthropic API 密钥,无按 token 计费。每个层级会跟踪你的套餐包含的最新模型(例如 [b]sonnet[/b] 当前解析为 Sonnet 5)。
[b]可选——Claude API 后端:[/b]在设置 → Claude AI 中输入你的 Anthropic API 密钥。无需本地 GPU 或 Ollama 模型——这是开始翻译最快的方式(按 token 计费)。
[heading]Ollama 模型[/heading]
自定义翻译微调模型[b]未发布在任何 hub 上[/b]——它们没有 [b]ollama pull[/b]。要翻译,请使用你的 [b]Claude Code 订阅[/b]或 [b]Claude API[/b](见上文两者,均无需 GPU),或从 GGUF 构建本地模型:
[list=1]
[*]下载 GGUF——例如来自 HuggingFace 的公开 [b]MamayLM[/b](乌克兰语):INSAIT-Institute/MamayLM-Gemma-3-12B-IT-v2.0——或使用你已有的任何 Gemma-3 / instruct [b].gguf[/b][/*]
[*]编辑随附的 [b]Modelfile[/b],将其 [b]FROM[/b] 行指向你下载的文件[/*]
[*]构建模型,然后在设置 → Ollama 中选择它:
[code]ollama create translategemma3-st -f Modelfile[/code][/*]
[/list]
应用自带系统提示词并在运行时覆盖所有生成参数,因此你创建的任何模型在设置 → Ollama 中选择后即可使用。
只有质量检查模型发布在 hub 上(可选):
[list]
[*][url=https://ollama.com/0xra/bethesda-qc][b]0xra/bethesda-qc[/b][/url]——专为 Bethesda 字符串质量检查微调的 Gemma 4 E4B。可检测 16 种问题代码并返回带有 AUTOFIX/RETRANSLATE 建议的结构化 VERDICT 块。
[code]ollama pull 0xra/bethesda-qc
ollama cp 0xra/bethesda-qc qcgemma4-st[/code][/*]
[/list]
[heading]功能[/heading]
[b]翻译[/b]
[list]
[*][b]并行 AI 翻译[/b]——可配置并发数,默认 10 个同时请求[/*]
[*][b]Claude API 后端[/b]——使用 Haiku 4.5、Sonnet 4.6 或 Opus 4.8 作为 Ollama 的即插即用替代方案;无需本地 GPU[/*]
[*][b]Claude Code 后端[/b]——通过本地 [b]claude[/b] CLI([b]claude-code:haiku / :sonnet / :opus[/b])在你的 Claude Code [b]订阅[/b]上运行翻译、聊天和审查,而非按量计费的 API;无 API 密钥,无按 token 成本[/*]
[*][b]AI 修复模式[/b]——不是从头重译,而是将现有有缺陷的翻译 + QC 问题描述发送给模型进行针对性修正;比完整重译更快、更精确[/*]
[*][b]语言对提示词[/b]——为每个源→目标组合提供专用系统提示词,包含语域规则、文字规范及母语示例[/*]
[*][b]翻译提示词编辑器[/b]——无需触碰代码即可自定义系统提示词:调节旋钮(语言风格、正式程度、词汇、语法、表达/本地化、严谨度)、按语言的风格/语域覆盖以及项目级指令,并实时预览组装后的提示词。适用于所有后端;占位符保护规则保持固定,因此游戏标签不会被破坏[/*]
[*][b]玩家性别感知翻译[/b]——英语“you”没有语法性别,但乌克兰语、波兰语、德语、俄语等有,因此 AI 否则会逐行猜测。只需声明一次玩家角色的性别,所有后端都会一致应用;警告会在批次运行[i]之前[/i]捕获未设置的性别,且仅当其中字符串确实指代玩家时[/*]
[*][b]官方术语挖掘器[/b]——游戏已在相同字符串 ID 上并列随附所有官方语言,因此该工具将英语与官方目标语言对齐,提取[b]Bethesda 自己的[/b]措辞用于每种武器、阵营、UI 动词和任务术语——且[b]零 AI 调用[/b]。真实安装中的 EN→DE:27 秒内产生 190,367 条翻译记忆条目和 17,815 条术语表术语。仅导入空行,因此进行中的工作永不被覆盖[/*]
[*][b]流水线后处理[/b]——每次翻译后对每条字符串执行处理:游戏标签恢复、大小写匹配、行前缀保留、换行修复、法式引号闭引号强制[/*]
[*][b]翻译记忆[/b]——已批准的字符串不再发送给模型;加载的 TM 跨会话保留,显示在状态栏中,并可在浏览器对话框中搜索[/*]
[*][b]持久缓存[/b]——SHA-256 键控,跨会话保留,最多 50,000 条[/*]
[*][b]术语保护器[/b]——8,000+ 个《星空》名称、地点和 UI 标签在 AI 看到文本前替换为占位符;专有名词永不被误译[/*]
[*][b]术语表系统[/b]——CSV/TBX/JSON 导入导出、应用内编辑器、自动注入 AI 提示词[/*]
[*][b]角色人设分析[/b]——为任何字符串或任务分配声音档案(自由星系游骑兵、SysDef 军官、猩红舰队海盗、瓦鲁恩家族狂热者、UC 平民、机器人/自动机、旁白或自定义);每个档案覆盖 AI 系统提示词和温度[/*]
[*][b]背景知识 RAG[/b]——本地 SQLite FTS5 背景知识数据库,内置 UESP 下载器;相关阵营、地点和角色文章注入每个 AI 提示词[/*]
[*][b]翻译前估算器[/b]——为每条字符串评分 0–100,在 AI 运行前预测翻译难度[/*]
[*][b]跳过字符串类型[/b]——从 AI 批量翻译中排除书籍、笔记或其他类别[/*]
[*][b]Claude 预检成本估算器[/b]——在开始批次前显示 token 数量和估算美元成本[/*]
[*][b]命名会话[/b]——跨多次使用保存和恢复搜索/过滤状态([b]Ctrl+Shift+N[/b] / [b]Ctrl+Shift+S[/b])[/*]
[*][b]宏录制器[/b]——录制和回放编辑操作序列([b]Ctrl+M[/b])[/*]
[/list]
[b]文件支持[/b]
[list]
[*][b].strings[/b]——空字符结尾的二进制格式[/*]
[*][b].dlstrings / .ilstrings[/b]——长度前缀的二进制格式[/*]
[*][b]BA2 归档[/b]——读写《星空》v2 和《辐射 4》v1 BA2 归档(GNRL/zlib);多条目归档的选择对话框[/*]
[*][b]ESP/ESM 插件[/b]——直接从非本地化插件中提取并写回可翻译字段[/*]
[*][b]ESP/ESM 模组更新迁移[/b]——以 FormID 为键对比插件的新旧版本,并将现有翻译前向迁移到更新版本(xTranslator 风格);风险着色的差异对比,带仅显示更改过滤器和 CSV/HTML 导出[/*]
[*][b]VMAD 脚本属性分析[/b]——解析附加到记录的 Papyrus 脚本属性字符串,将每个值分类为可翻译/需审查/锁定(资源路径、事件名称、标识符),并仅对已编辑值进行字节拼接,使未建模的脚本结构原样保留;适用于本地化和非本地化插件[/*]
[*][b]《星空》界面 TXT[/b]——[b]translate_en.txt[/b] / [b]translate_ru.txt[/b] key=value 界面字符串文件[/*]
[*][b]xTranslator SST XML[/b]——与现有 xTranslator 项目兼容的导入导出[/*]
[*][b]编码检测[/b]——自动检测 UTF-8 BOM、UTF-8、CP1251、CP1252、CP1250(波兰语)、GBK;可按文件覆盖[/*]
[*][b]翻译文件夹验证器[/b]——对照游戏的 Data 文件夹(散装文件[i]以及[/i]BA2 归档)扫描你完成的翻译,列出所有会引发游戏内 [b]“Unknown lstring ID”[/b] 错误的文件和 ID——在你启动游戏之前[/*]
[*][b]配套字符串查看器[/b]——以只读方式查看已加载的 .strings/.dlstrings/.ilstrings 三元组,带文件类型和文本/ID 过滤器。这三个文件有独立的 ID 空间,因此配套文件作为参考加载,永不合并到你保存的文件中[/*]
[*][b]拖放[/b]文件加载,带格式验证[/*]
[/list]
[b]质量保证[/b]
[list]
[*][b]质量检查器[/b]——20+ 项自动检查:缺失/多余的游戏标签、空或未翻译的字符串、源语言泄漏、英语泄漏、可疑长度比例、换行不匹配、AI 输出截断、AI 残留前缀、编码失败、未闭合的法式引号、不匹配的括号、CJK 文字覆盖率以及术语表不匹配[/*]
[*][b]AI 质量模型[/b](qcgemma4-st)——微调的 Gemma 4 E4B,检查翻译并返回带 AUTOFIX/RETRANSLATE 建议和思维链推理的结构化裁决[/*]
[*][b]字体和字形检查器[/b]——解析 Scaleform SWF 字体图集和 TTF/OTF cmap 表;标记游戏中将渲染为方块的翻译字符,并建议可自动修复的替代字符[/*]
[*][b]UI 宽度适配模拟器[/b]——字形检查器证明字符存在;此模拟器证明它拼出的标签[i]适合其框[/i]。西里尔文、德语和波兰语比英语长 15–30%,而 Scaleform 控件[b]裁剪而非缩小[/b]——因此拼写完美的翻译发布后仍会是截断的按钮。宽度根据实际游戏字体的真实逐字形步进值测量,而非根据字符数估算,并且每行还显示翻译宽度与英语宽度(后者按构建即适合)的对比[/*]
[*][b]从游戏自身菜单读取的真实控件边界[/b]——将其指向你的 Data 文件夹,它会读取每个 Interface SWF 和 BA2(约 250 个文件,约 2560 个裁剪字段),直接从游戏中获取每个控件的设定宽度、边距、裁剪行为和字体。没有猜测的预算:它会标记字号是由菜单指定还是从框中推断,因为 20% 的字号错误就是 20% 的错误裁决[/*]
[*][b]大字体(无障碍)菜单按最坏情况检查[/b]——《星空》为大多数菜单提供大字体版本,其中框通常保持不变而文本增大(最高 ×2.64)。一个标签可能通过普通菜单,但仅对使用大字体的玩家被裁剪——这正是发布后未被注意到的 bug。每个控件会选取更紧凑的版本,且工具始终标明它测量的是哪一个——因此沉默绝不悄悄意味着“未检查”[/*]
[*][b]韩语助词(조사)检查器[/b]——异形词根据韩文받침算术计算,绝不猜测。捕获占位符后的单一形式助词(替换名词的尾辅音在翻译时无法得知,且引擎不解析任何内容)以及助词/词干不匹配。在 5,353 条真实韩语字符串中测得 0 误报;两者均可自动修复[/*]
[*][b]Hunspell 拼写检查[/b]——可选的按语言拼写检查;Windows/macOS 构建随附词典,在 Linux 上使用 [b]pacman -S hunspell-uk[/b] 或 [b]apt install hunspell-uk[/b] 安装系统词典[/*]
[*][b]全部自动修复[/b]——一键批量修复所有机械性可纠正的问题(空白、大小写、字符替换、缺失换行、未闭合法式引号)[/*]
[*][b]按代码隐藏过滤器[/b]——在当前会话中从结果表中抑制特定 QC 问题代码[/*]
[*][b]重译队列[/b]——QC 标记的字符串排队并使用描述出错原因的逐字符串提示重译[/*]
[*][b]一致性检查器[/b]——查找相同源字符串翻译不同的情况;选择一个规范形式并批量替换([b]Ctrl+Alt+K[/b])[/*]
[*][b]乌克兰语性别检查器[/b]——检测形容词/名词性别一致性不匹配([b]Ctrl+Alt+G[/b])[/*]
[*][b]ти/ви 语域一致性[/b]——非正式 ти / 正式 ви 由翻译提示词(Ollama 和 Claude 后端均是)直接按说话者保持一致,因此混合称呼从一开始就不会进入输出[/*]
[*][b]插件验证器[/b]——扫描 ESP/ESM 中的 NPC 对话摄像机 bug:缺少 Localized 标志、杂散的 DIAL/SCEN/INFO 记录、ONAM 覆盖、缺失的主依赖[/*]
[*][b]版本差异[/b]——比较两个游戏版本并迁移未更改的翻译;导出 CSV/HTML 报告[/*]
[/list]
[b]审查工具[/b]
[list]
[*][b]可视上下文预览[/b]([b]Ctrl+Shift+P[/b])——可停靠面板,使用从 SWF 资源中提取的实际游戏字体,在忠实还原的 Bethesda 游戏内 UI 中渲染当前字符串;自动检测上下文类型(对话、任务、书籍、笔记、终端、UI),并显示长度关键字符串的实时适配指示([b]Tab 标签:262/220px (119%) 裁剪[/b]),对照真实控件预算测量[/*]
[*][b]对话树可视化器[/b]——交互式 任务 → 主题 → 响应 节点图([b]Ctrl+Shift+T[/b]),带《星空》深空视觉主题;点击任意节点跳转到表格中的该字符串[/*]
[*][b]音频 / TTS 预览[/b]([b]Ctrl+Shift+A[/b])——合成翻译的 TTS 朗读以进行时长比较;eSpeak-NG 和 Piper 后端;颜色编码的时长条[/*]
[*][b]原生《星空》语音播放[/b]——直接从游戏的 Voices BA2 归档中解码对话行的原始 Wwise [b].wem[/b] 语音片段(FormID → 语音片段,通过 vgmstream-cli),并与 TTS 朗读一起回放;在 ESP/ESM 模式下,该行的 FormID 自动填充[/*]
[*][b]说话者(NPC)面板[/b]——通过解析 Wwise 语音类型文件夹名,显示所选对话行的配音者(姓名、性别、阵营、类别、原始语音类型,以及共享行的“也由……配音”)[/*]
[*][b]差异查看器[/b]——源文与译文的并排单词级或字符级差异;可编辑右窗格并实时更新差异;HTML 导出[/*]
[*][b]高级搜索[/b]——跨源列和翻译列的正则和模糊搜索;批量查找和替换[/*]
[/list]
[b]NexusMods 集成[/b]
[list]
[*][b]使用 Nexus Mods 登录[/b]——通过官方基于浏览器的单点登录流程一键登录账户(设置 → NexusMods);无需粘贴 API 密钥,你的个人密钥永不离开你的机器[/*]
[*][b]模组浏览器[/b]——直接从应用内搜索 NexusMods(文件 → 浏览 NexusMods…);卡片网格结果带缩略图、认可数和下载量[/*]
[*][b]免费用户下载[/b]——通过复用你活跃的浏览器会话(Firefox 或 Chromium),无需 Premium 订阅即可下载;无需 NXM 处理器或手动点击[/*]
[*][b]归档提取[/b]——自动从 .zip、.7z 和 .rar 模组归档中提取 .esp/.esm/.esl 文件并直接在编辑器中打开[/*]
[*][b]翻译记忆导入[/b]——从 NexusMods 下载翻译模组并一键加载为 TM;已知字符串预填充并被 AI 跳过[/*]
[/list]
[b]UI / 工作流[/b]
[list]
[*][b]禅 / 专注模式[/b]([b]F11[/b])——全屏覆盖层,一次显示一条字符串,实现无干扰翻译;带待处理字符串计数器和逐字符串状态徽章[/*]
[*][b]多显示器支持[/b]——翻译编辑器停靠面板([b]Ctrl+Shift+E[/b])可浮动到任意显示器;弹出字符串列表([b]Ctrl+Shift+L[/b])打开镜像表格窗口[/*]
[*][b]Claude AI 助手停靠面板[/b]([b]Ctrl+Shift+C[/b])——就当前字符串聊天并一键应用 Claude 建议的翻译;可选连接远程 [b]MCP 服务器[/b](设置 → Claude MCP 服务器),以便 Claude 在你聊天时调用外部工具[/*]
[*][b]应用到所有相同原文[/b]([b]Ctrl+Alt+D[/b])——一次将一行的翻译传播到所有具有相同源文本的行;[b]Delete[/b] 清除翻译并将该行恢复为待处理[/*]
[*][b]命令面板[/b]([b]Ctrl+K[/b])和 vim 风格导航(j/k、G)[/*]
[*][b]键盘快捷键编辑器[/b]——重新绑定任意操作[/*]
[*][b]F7[/b] → 下一条未翻译 · [b]Ctrl+Enter[/b] → 批准 · [b]Ctrl+R[/b] → 拒绝[/*]
[*][b]16 个内置主题[/b]——Slate、Midnight、Nord、Dracula、Catppuccin、Light、Solarized Dark、Solarized Light、Gruvbox、Tokyo Night、Monokai、One Dark、Sepia、Starfield、Starfield Terminal、High Contrast;另支持自定义 QSS 文件[/*]
[*][b]GPU 监控[/b]——状态栏中实时显示 GPU%、VRAM 使用量和温度;颜色编码绿/黄/红(Linux 上为 AMD,所有平台上为 NVIDIA)[/*]
[*][b]Ollama 模型自动检测[/b]——设置中的模型选择器自动加载已安装模型并在打开时持续刷新,因此刚 [b]ollama pull[/b] 的模型无需点击刷新即可出现[/*]
[*][b]Ollama 强制停止[/b]——无需离开应用即可重启 Ollama 服务以释放卡住的 GPU;在 Linux 上,特权重启使用应用自带的主题化密码对话框(sudo -S,带 askpass/pkexec 回退),在 Windows 上通过 taskkill 停止服务[/*]
[*][b]界面翻译[/b]——UI 提供乌克兰语 ✓、德语、西班牙语、法语、波兰语、捷克语、韩语(社区进行中)[/*]
[*][b]跨平台桌面通知[/b],在批次完成时——Linux 上为 notify-send/D-Bus,Windows 和 macOS 上为原生系统托盘气泡[/*]
[*][b]原生操作系统集成[/b]——Windows 和 macOS 上为原生资源管理器/访达文件对话框;配置存储在操作系统原生位置(%APPDATA% / Application Support / XDG),仅所有者文件权限[/*]
[*][b]“新增内容”面板[/b]——从 GitHub 获取最新发行说明并显示在欢迎屏幕上[/*]
[*][b]自动更新检查[/b]——启动时检查较新版本并提供下载(在设置中切换)[/*]
[*][b]崩溃恢复[/b]——定期自动保存;如果上次会话意外结束,启动时提供恢复对话框[/*]
[*][b]安全审计日志[/b]——所有文件操作和翻译批次的仅追加 JSON-lines 日志;API 密钥存储在系统密钥环中,带 AES-256-GCM 文件回退[/*]
[*]状态栏,在 AI 批次期间实时显示进度、已翻译计数和预计剩余时间[/*]
[/list]
[heading]系统要求[/heading]
使用 AI 翻译功能时 [url=https://ollama.com]Ollama[/url] 必须在本地运行([b]localhost:11434[/b])。或者使用 [b]Claude API[/b] 后端(在设置中输入你的 Anthropic API 密钥)或 [b]Claude Code[/b] 后端(安装 [url=https://claude.com/claude-code]Claude Code[/url] 并登录——在你的订阅上运行,无 API 成本)——两者均无需本地 GPU。
[b]最低硬件:[/b]推荐 8 GB VRAM 用于 Gemma 3 12B Q4 翻译模型。独立构建包含其他一切(Python 运行时、Qt 库)——无需单独安装。
[heading]致谢[/heading]
[list]
[*][b]Diranar 的 xTranslator[/b]——Bethesda 本地化的原始且不可或缺的工具。本编辑器中的 SST XML 格式和字段定义基于 xTranslator 的逻辑。[/*]
[*][b]Ollama[/b]——让本地 AI 推理简化到只需一条命令。[/*]
[*][b]《星空》乌克兰语本地化社区[/b]——感谢塑造此工具的反馈、术语列表和实际测试。[/*]
[/list]
正在加载版本记录…
正在加载评论…
评论在新手盒子客户端中发表,这里同步展示。